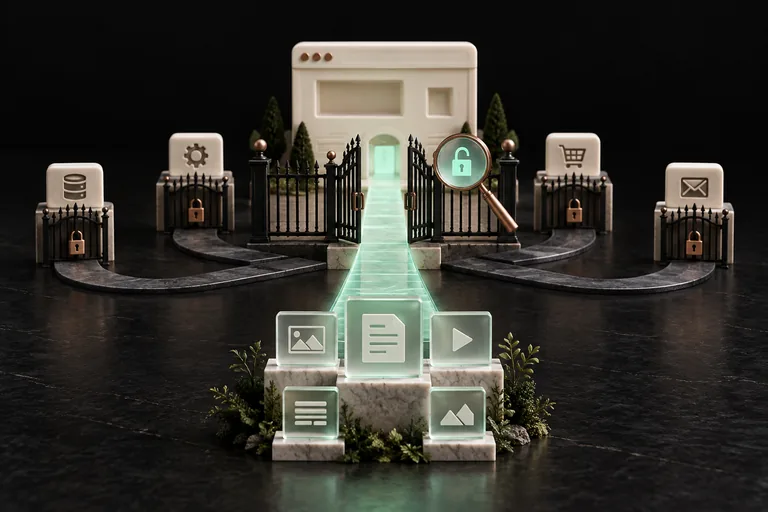
想象一座博物馆正在发布新一季展览。公众可以阅读活动日历和参观说明,工作人员则在账户区域管理日常事务。网站为不同读者安排了各自需要的内容与入口。
在这个假设例子中,robots.txt帮助组织抓取路径;索引指令、链接和账户权限分别承担其他职责。了解这些工具如何配合,就能把公开内容的发布流程规划得更清楚。
1. 为抓取说明安排一个明确的位置
Robots.txt是放在网站根路径的纯文本文件。遵循Robots Exclusion Protocol的抓取工具会读取其中的指令,再按照适用规则安排请求。对网站维护者而言,它为抓取策略提供了一个统一的位置。
可以按职责理解各项机制:robots.txt指导抓取,账户认证和授权控制受保护内容的访问。博物馆的公开展览与工作人员区域各有合适的使用方式。Google的robots.txt介绍说明了文件在抓取流程中的作用。
规则与具体源站相关:协议、主机名和端口共同确定访问位置。主站和子域名可以分别拥有自己的文件。随着网站增加新区域,记录各个源站的用途,并从实际地址读取其规则,是便于维护的好习惯。
2. 为每个目标选择合适的机制
| 目标 | 机制 | 实用做法 |
|---|---|---|
| 引导抓取工具访问合适的网址空间 | robots.txt | 清楚定义路径,并测试实际网址 |
| 让可访问页面保持在搜索结果之外 | 受支持的noindex指令 | 让抓取工具能够读取该指令 |
| 为工作人员提供账户内容 | 认证与授权 | 使用合适的账户和访问权限 |
| 帮助发现公开内容 | 内部链接与站点地图 | 一致地使用首选公开网址 |
例如,一张公开可访问的确认页面可以使用noindex表达索引偏好,同时保持可抓取,以便搜索引擎读取指令。Google的索引控制说明介绍了这种配合方式。先说清页面的目的,再选择机制,能够让每项设置各司其职。
3. 用具体规则表达清晰意图
User-agent选择规则适用的抓取工具,Disallow和Allow描述路径的抓取安排。Google会区分路径大小写,并依据最具体的匹配规则处理请求;在同等具体程度时采用允许规则。具体行为可查阅Google的robots.txt规范说明。
User-agent: *
Disallow: /internal/
Allow: /internal/public-calendar.json$
Sitemap: https://example.com/sitemap.xml这是一份用于解释语法的示例:一般抓取避开/internal/区域,同时保留一个明确的公开日历数据入口。$表示模式末尾。包含查询参数的地址应按照实际请求形式进行匹配检查。
宽泛路径和精确例外可以配合使用。为每条规则记录用途,并同时测试目标地址与相邻地址,团队就更容易理解政策,也便于将来扩展公开内容时作出一致选择。
4. 一起规划构成页面的资源
博物馆的活动日历可能由公开页面、脚本、样式和数据共同构成。通过浏览器的网络请求,可以了解每个资源如何参与页面呈现,再把这些路径纳入整体发布计划。
对比初始HTML与浏览器呈现后的内容,有助于理解标题、活动日期和导航在哪里生成。Google的JavaScript SEO说明介绍了搜索引擎处理这些资源的过程。这种观察也让编辑与开发团队能够用同一张页面讨论发布效果。
向访客提供的公开数据可以使用清晰的公开路径;账户内容则采用正常的权限设计。把资源用途与页面用途对应起来,可以让日历、展览介绍和工作人员工具分别拥有合适的交付方式。
5. 建立一份简短的发布清单
一份轻量的清单可以把抓取政策放进常规发布流程:
- 列出计划公开的页面与主要资源。
- 确认对应源站,以及要检查的抓取工具规则。
- 查看响应、重定向和页面元信息。
- 跟随主要内容所使用的脚本、样式与数据。
- 协调首选网址、canonical和站点地图。
- 记录检查时间与发布目的。
对博物馆而言,日历、展览页面和参观指南可以分别选取一个有代表性的网址。把合适的做法应用到共享模板,有助于让整个内容集合保持一致。新增栏目或参数形式时,再把代表性地址加入清单即可。
安排工作时可以从受众出发:经常访问的公开内容适合拥有简单清楚的路径,管理事务则按照账户访问需求设计。抓取政策因此成为服务不同读者的一部分,而每次发布也都有明确的核对依据。
6. 确认已发布政策,观察页面旅程
从准确的公开地址读取robots.txt,查看实际发布的内容,再测试主要匹配、明确例外和邻近路径。随后按访客的方式打开页面,确认主要文字、日期和导航的呈现。这些观察可以共同记录在发布清单中。
抓取工具会缓存规则,索引处理也有各自的时间线。Search Console的页面索引报告帮助观察已经处理的状态;站点地图与请求索引则可以配合内容发现。整个过程中持续使用同一组首选网址,便于连接各阶段的记录。
比较后续表现时,选择完整时间段,并保持页面、搜索类型、国家和设备等条件一致。记录内容发布和推广活动,可以为数据变化提供背景。对小型网站来说,持续积累观察同样有用:公开可访问、进入索引与获得有价值的访问,分别是值得跟踪的进展。
7. 将抓取观察接入网站维护
Sitelemetry的SEO检查可以整理robots.txt和页面索引相关观察,帮助把网址、规则与发布目的对应起来。结合实时页面和搜索工具的信息,可以逐步完善公开内容的组织方式。继续阅读技术SEO指南了解整条发现旅程,或使用网站检查术语指南统一团队的日常表达。
常见问题
Robots.txt与noindex如何分工?
Robots.txt指导抓取请求;noindex表达页面的索引偏好。需要使用noindex时,让抓取工具能够获取页面或响应头,读取相应指令。
怎样为公开内容选择抓取规则?
先明确哪些页面与资源面向公众,再依据实际网址形式设计规则,并检查代表性地址和例外路径。内部链接与站点地图也应使用一致的公开网址。
JavaScript页面可以怎样检查?
查看访客使用的公开页面和资源,对比初始HTML与浏览器呈现后的内容,跟随标题、日期和导航等关键信息的生成过程。
怎样观察规则发布后的进展?
记录公开文件、实时页面和索引状态,再用条件一致的完整时间段观察搜索表现。同时记录内容更新与推广活动,为后续分析提供背景。
来源与延伸阅读
- Google搜索中心:robots.txt介绍developers.google.com
- Google搜索中心:使用noindex控制索引developers.google.com
- Google抓取文档:robots.txt规范developers.google.com
- Google搜索中心:JavaScript SEO基础developers.google.com
- Google Search Console帮助:页面索引报告support.google.com

由 Sitelemetry 编辑团队编写。文末的一手资料可帮助你深入了解相关主题。