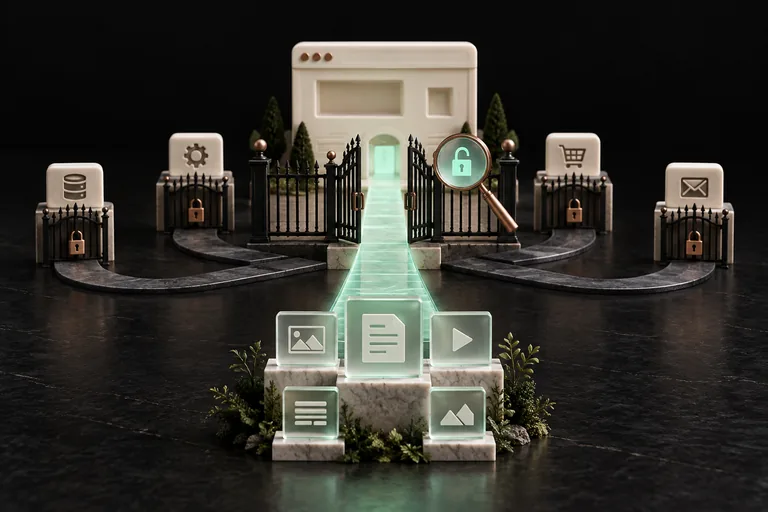
Immagina un museo che prepara una stagione di mostre. Il sito presenta programma, calendario pubblico e informazioni per la visita, mentre il personale lavora in un’area account separata. Ogni parte serve il proprio pubblico.
Questo esempio ipotetico rende concreta la politica dei crawler. Le pagine pubbliche hanno percorsi di scoperta, le risorse una distribuzione appropriata e gli account i propri controlli di accesso. Ogni meccanismo ha un ruolo chiaro.
1. Dare alle istruzioni una sede chiara
Robots.txt raccoglie istruzioni alla radice del sito, per esempio https://example.com/robots.txt. I crawler cooperativi consultano questo testo per decidere quali URL richiedere. La politica di scansione ha una sede comune.
Distribuisci i compiti: robots guida i crawler, autenticazione e autorizzazione gestiscono i contenuti privati. L’introduzione di Google ne spiega gli scopi. Mostre e account del personale possono seguire politiche adatte ai rispettivi utenti.
Le regole appartengono a schema, host e porta. Rivedi ogni origine che pubblica, inclusi i sottodomini. Usare l’origine esatta facilita documentazione e test mentre il sito cresce.
2. Scegliere secondo l’obiettivo editoriale
| Obiettivo | Meccanismo | Buona pratica |
|---|---|---|
| Guidare la scansione verso URL utili | Robots.txt | Definire e provare i percorsi |
| Tenere una pagina accessibile fuori dai risultati | Noindex supportato | Consentire il recupero della direttiva |
| Offrire contenuti al personale | Autenticazione e autorizzazione | Dare accesso all’account appropriato |
| Favorire la scoperta di pagine pubbliche | Link e sitemap | Usare URL preferiti coerenti |
Parti dallo scopo. Una conferma pubblica può avere noindex e restare recuperabile per leggere l’istruzione. La guida a noindex ne spiega la pubblicazione.
3. Costruire regole precise dall’agente al percorso
Un gruppo comincia con User-agent, che identifica il crawler. Disallow e Allow descrivono percorsi. In Google contano le maiuscole, prevale la regola più specifica e a parità vince Allow. Consulta la documentazione del crawler pertinente.
User-agent: *
Disallow: /internal/
Allow: /internal/public-calendar.json$
Sitemap: https://example.com/sitemap.xml
La politica illustrativa riserva il percorso interno rispetto alla scansione generale e consente esattamente un calendario volutamente pubblico. $ indica la fine del modello. Includi gli URL con parametri reali nei test e scegli il loro trattamento.
La specifica di corrispondenza aiuta a combinare regole ampie ed eccezioni precise. Documenta il motivo di ogni eccezione per facilitarne la gestione da parte di un altro redattore.
4. Pianificare le risorse che compongono la pagina
Il calendario può unire pagina pubblica, script, stili e dati. Identifica i componenti nella vista di rete e il loro contributo all’esperienza. Il piano di pubblicazione comprende pagina e risorse di presentazione.
Confronta la risposta iniziale con il rendering dal vivo. Vedi dove si formano titoli, date e navigazione. La documentazione JavaScript SEO spiega il lavoro congiunto di recupero e rendering.
I dati pubblici utilizzano una distribuzione pubblica appropriata; le operazioni di account seguono i permessi consueti. Ogni risorsa ha uno scopo: dati per il calendario, stili per presentare, endpoint del personale per attività autenticate.
5. Creare una piccola lista di pubblicazione
- Elenca le pagine pubbliche da far scoprire.
- Registra origine esatta e gruppo applicabile.
- Rivedi risposta, reindirizzamenti e metadati.
- Segui le risorse del contenuto principale.
- Allinea canonical e sitemap.
- Annota le date di revisione della pagina e dell’indicizzazione.
La politica diventa un’abitudine editoriale. Mostra, calendario e guida alla visita possono condividere un template; una buona pratica sostiene l’intera raccolta. Aggiungi URL rappresentativi per nuove sezioni e parametri.
Stabilisci priorità secondo pubblico e scopo. L’informazione pubblica frequente merita una strada semplice; l’amministrazione usa il proprio accesso. Chiediti come ogni parte serve il lettore e come la politica esprime quella scelta.
6. Confermare la politica e osservare il percorso
Dopo la pubblicazione, recupera robots.txt e controlla il contenuto esatto. Prova percorsi corrispondenti, eccezione e indirizzi vicini. Apri la pagina da visitatore e conferma le informazioni principali nel rendering. Conserva le evidenze insieme alla decisione.
I sistemi possono memorizzare le regole in cache; l’indicizzazione segue i tempi di elaborazione. Il rapporto di indicizzazione aiuta a osservarli. Sitemap e richiesta di indicizzazione sostengono la scoperta e offrono un riferimento coerente.
Confronta poi periodi completi con gli stessi filtri di pagina, ricerca, paese e dispositivo. Registra pubblicazioni e campagne per mantenere il contesto. Un sito piccolo può beneficiare di un periodo più lungo. Segui accesso pubblico, indicizzazione e visite utili.
7. Integrare le osservazioni nella routine
Sitelemetry può raccogliere osservazioni su robots, pagine e indicizzazione in un audit SEO. Mantieni insieme URL, regola e scopo, con la pagina e gli strumenti del motore. La guida alla SEO tecnica amplia il percorso, il glossario offre definizioni.
Domande frequenti
Come collaborano robots.txt e noindex?
Robots.txt guida la scansione. Noindex comunica una scelta di indicizzazione in una risposta accessibile. Mantieni recuperabile la direttiva perché il crawler possa leggerla.
Come scelgo una politica di scansione?
Parti dai contenuti pubblici da diffondere e dai servizi desiderati. Definisci modelli di URL e prova pagine e risorse rappresentative.
Come rivedo il contenuto pubblico di una pagina JavaScript?
Aprila da visitatore, esamina risorse e confronta risposta iniziale e rendering. Segui la produzione di testo, date e navigazione.
Come osservo l’effetto della politica pubblicata?
Conferma file e pagina, segui l’indicizzazione e confronta la ricerca in periodi coerenti. Registra contenuti e campagne accanto alla politica.
Fonti e approfondimenti
- Google: introduzione a robots.txtdevelopers.google.com
- Google: pubblicare noindexdevelopers.google.com
- Google: corrispondenza delle regole robots.txtdevelopers.google.com
- Google: fondamenti di JavaScript SEOdevelopers.google.com
- Google: rapporto di indicizzazione delle paginesupport.google.com

A cura della redazione di Sitelemetry. Le fonti collegate permettono di approfondire gli argomenti.